
 SEO
 Техподдержка
 Видеопродакшн
 Реклама
 AI-интеграция
 Брендинг
 Разработка
Что такое RAG-система: как научить ИИ работать с данными компании
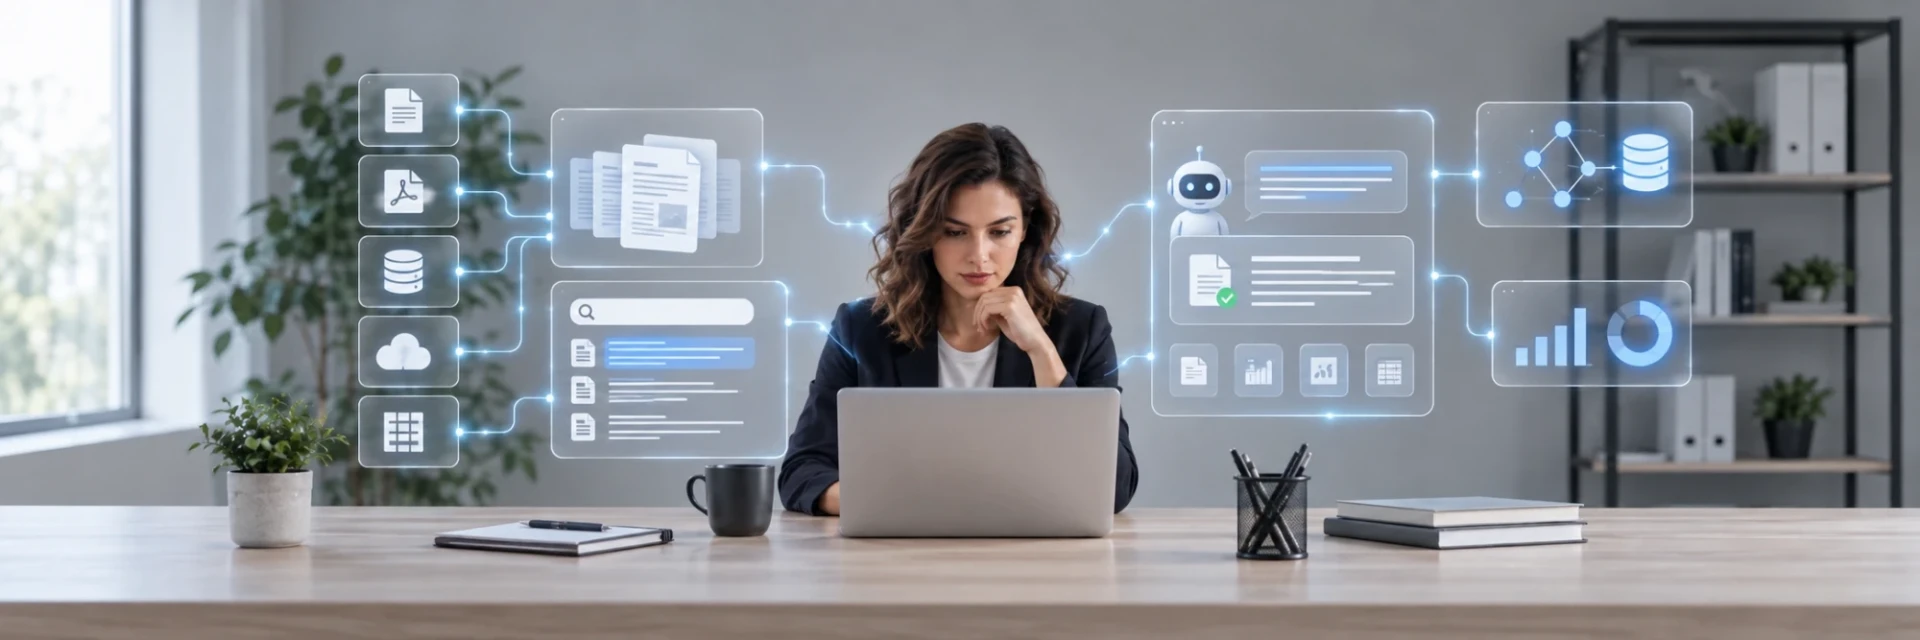
Современная нейросеть умеет написать письмо, пересказать документ, проанализировать текст или ответить на сложный вопрос.
Но у бизнеса быстро возникает проблема.
Нейросеть не знает автоматически:
- актуальный прайс компании;
- внутренние регламенты;
- технические инструкции;
- условия договоров;
- характеристики конкретного оборудования;
- ассортимент;
- корпоративные правила;
- историю проектов;
- внутреннюю базу знаний.
Можно каждый раз вручную прикладывать документ к запросу.
Если файлов пять и задач немного — этого иногда достаточно.
Но что делать, если документов тысячи, информация регулярно обновляется, а сотрудникам или клиентам ежедневно нужно получать ответы по корпоративным данным?
Для этого используется RAG — Retrieval-Augmented Generation.
Если говорить простыми словами, RAG позволяет перед ответом автоматически найти нужную информацию в базе знаний компании и передать её нейросети.
Вместо того чтобы спрашивать модель:
«Какие условия возврата действуют в нашей компании?»
и надеяться на её общие знания, система сначала находит актуальный внутренний регламент, извлекает нужный раздел и только после этого формирует ответ.
Получается цепочка:
вопрос → поиск по корпоративным данным → нужные фрагменты → нейросеть → ответ на основе найденной информации.
Именно поэтому RAG особенно интересен компаниям, где сотрудники регулярно ищут информацию в документах, инструкциях, каталогах, регламентах и других внутренних источниках.
Разберём, что такое RAG, как он работает, какие данные можно подключить, когда эта технология действительно нужна бизнесу, чем RAG отличается от fine-tuning и ИИ-агентов и как понять, что внедрение даёт реальный результат.
Что такое RAG простыми словами
RAG расшифровывается как Retrieval-Augmented Generation — генерация с дополненной выборкой или генерация с использованием найденной информации.
Суть подхода довольно простая.
Обычная языковая модель формирует ответ на основе знаний, полученных во время обучения, и информации, которую пользователь передал непосредственно в запросе.
RAG добавляет ещё один этап.
Перед формированием ответа система сначала ищет релевантную информацию во внешнем источнике данных.
Это может быть:
- корпоративная база знаний;
- набор документов;
- сайт;
- техническая документация;
- инструкции;
- внутренний портал;
- каталог;
- база обращений;
- CRM;
- другая информационная система.
После поиска найденные фрагменты передаются языковой модели вместе с вопросом пользователя.
И уже на их основе формируется ответ.
То есть RAG не «загружает знания внутрь нейросети навсегда».
Он каждый раз даёт модели нужную информацию непосредственно перед ответом.
В этом одно из главных преимуществ подхода: если данные изменились, не требуется заново обучать языковую модель. Достаточно обновить источник или поисковый индекс.
Зачем RAG нужен, если нейросети и так многое знают
Современные языковые модели действительно обладают огромным объёмом общих знаний.
Но для корпоративной системы этого недостаточно.
Есть как минимум три фундаментальные проблемы.
Нейросеть не знает внутренних данных компании
Обычная модель не знает автоматически:
- какой прайс действует сегодня;
- какие условия прописаны в вашем договоре;
- какие скидки разрешены менеджеру;
- какая редакция инструкции сейчас актуальна;
- какие товары есть в ассортименте;
- что написано во внутреннем регламенте;
- какие документы выдаются после конкретного курса.
Эти данные никогда не были частью общего обучения модели либо изменились уже после него.
Знания модели могут быть устаревшими
Бизнес-информация меняется постоянно.
Сегодня компания изменила тариф.
Завтра обновила договор.
Через неделю появился новый продукт.
Через месяц изменился внутренний процесс.
Дообучать большую языковую модель после каждого такого изменения практически бессмысленно.
RAG позволяет оставить модель как есть и обновлять только данные, из которых она получает информацию.
Модель может придумать убедительный ответ
Одна из особенностей генеративных моделей — они стараются сформировать ответ даже тогда, когда достоверной информации недостаточно.
В результате текст может звучать уверенно, но содержать выдуманный факт.
RAG снижает этот риск, потому что система получает конкретные источники непосредственно перед генерацией.
Но важное ограничение:
RAG уменьшает вероятность галлюцинаций, а не устраняет её полностью.
Ошибиться может как поиск, так и сама модель при интерпретации найденного материала.
Простой пример: обычный ИИ и ИИ с RAG
Представим, что сотрудник спрашивает корпоративного помощника:
«Через сколько дней клиент может вернуть товар?»
Обычная нейросеть
Модель пытается ответить на основе общих знаний.
Она может:
- рассказать общие правила возврата;
- сослаться на законодательство;
- предположить срок;
- не учесть специфику конкретного товара;
- не знать внутренний регламент компании.
Ответ может выглядеть вполне убедительно, но быть бесполезным для конкретной ситуации.
RAG-система
Сначала система ищет информацию.
Например, находит:
Регламент возврата → раздел 4.2 → редакция от 12 августа 2026 года.
Этот фрагмент передаётся модели.
И уже после этого формируется ответ.
Дополнительно пользователю можно показать:
- название документа;
- раздел;
- дату версии;
- ссылку на источник.
В результате сотрудник получает не просто текст от нейросети, а ответ, который можно проверить.
Именно проверяемость — одна из наиболее важных характеристик корпоративных RAG-систем.
Как работает RAG
Под капотом RAG может быть достаточно сложным.
Но с точки зрения бизнеса процесс удобно разделить на две большие части:
- подготовка базы знаний;
- обработка пользовательского запроса.
Как подготавливается база знаний
Шаг 1. Система получает документы
Например:
- PDF;
- Word;
- страницы сайта;
- инструкции;
- договоры;
- карточки товаров;
- внутренние регламенты.
Шаг 2. Информация очищается
Из документов желательно убрать всё, что мешает поиску:
- повторяющиеся колонтитулы;
- мусорные символы;
- технические элементы;
- дубли;
- устаревшие версии.
На этом же этапе может потребоваться распознавание сканов.
Шаг 3. Документы делятся на фрагменты
Большую инструкцию на 300 страниц обычно не отправляют языковой модели целиком.
Текст делят на логические части — чанки.
Шаг 4. Фрагменты индексируются
Система создаёт представление, по которому потом можно быстро искать подходящие части текста.
Часто для этого используются эмбеддинги и векторный поиск.
Шаг 5. Сохраняются дополнительные данные
Например:
- название документа;
- дата;
- версия;
- отдел;
- тип документа;
- категория продукта;
- уровень доступа.
Эти данные называются метаданными и могут сильно улучшить качество поиска.
Что происходит после вопроса пользователя
Пользователь спрашивает:
«Какой срок гарантии у оборудования серии X?»
Дальше система:
- анализирует вопрос;
- ищет релевантные фрагменты в базе;
- отбирает наиболее подходящие;
- при необходимости дополнительно переранжирует результаты;
- передаёт вопрос и найденные данные языковой модели;
- модель формирует итоговый ответ;
- система показывает ответ и, при необходимости, ссылки на источники.
Что такое чанки и зачем документы делить на части
Чанк — это отдельный фрагмент исходного документа.
Например, инструкция может быть разделена:
- по главам;
- подразделам;
- абзацам;
- логическим смысловым блокам.
Зачем вообще это делать?
Представим, что в инструкции 250 страниц.
Пользователь спрашивает:
«Как часто нужно менять воздушный фильтр?»
Для ответа системе может быть нужен всего один небольшой раздел.
Нет смысла передавать модели весь документ.
RAG должен найти именно тот фрагмент, где содержится ответ.
Но здесь появляется важная инженерная задача.
Если чанк слишком большой
Вместе с нужным фактом модель получает много лишней информации.
Это увеличивает шум и стоимость обработки.
Если чанк слишком маленький
Можно разорвать смысл.
Например, в одном фрагменте окажется название параметра, а его значение — уже в другом.
Поэтому универсального идеального размера чанка нет.
Его подбирают исходя из типа документов и реальных пользовательских вопросов.
Что такое эмбеддинги и векторный поиск
Обычный поиск хорошо работает, когда пользователь использует те же слова, что и в документе.
Но люди редко формулируют вопросы точно так же, как автор инструкции.
Например, человек спрашивает:
«Сколько действует гарантия?»
А в документе написано:
«Гарантийный срок составляет 24 месяца с даты продажи».
По словам запрос и документ отличаются.
По смыслу — совпадают.
Для поиска таких совпадений текст можно преобразовать в математическое представление — embedding.
Очень упрощённо:
тексты с похожим смыслом получают похожее числовое представление.
После этого система может искать не только совпадающие слова, но и близкие по смыслу фрагменты.
Это и является одной из причин популярности векторного поиска в RAG.
Только ли векторный поиск нужен RAG
Нет.
Это важный момент.
Для части задач семантический поиск действительно работает отлично.
Например:
«Как сотруднику оформить командировку?»
Но представим другой запрос:
«Найди инструкцию к модели ABX-219-08».
Здесь точное совпадение артикула может быть важнее смысловой близости.
Поэтому в реальных системах могут комбинироваться:
- полнотекстовый поиск;
- поиск по ключевым словам;
- векторный поиск;
- фильтры;
- поиск по метаданным;
- гибридные методы;
- reranking.
Reranker дополнительно оценивает найденные фрагменты и пытается расположить наиболее полезные выше остальных.
В результате хорошая RAG-система часто устроена сложнее, чем:
«превратили все PDF в векторы и ищем ближайшие фрагменты».
Из чего состоит RAG-система
Упрощённая архитектура выглядит следующим образом.
Источники данных
Место, где находится корпоративная информация.
Модуль загрузки и обновления
Он получает новые документы, обрабатывает изменения и обновляет индекс.
Поисковый индекс
Структура, по которой система находит релевантные данные.
Это может быть векторная база, поисковый движок или сочетание нескольких технологий.
Retriever
Компонент, который по запросу пользователя находит подходящие фрагменты.
Reranker
Дополнительно переоценивает результаты и выбирает самые релевантные.
Языковая модель
Формирует понятный человеку ответ на основе найденной информации.
Интерфейс
Например:
- чат на сайте;
- окно внутри корпоративного портала;
- Telegram;
- CRM;
- отдельный веб-интерфейс.
Мониторинг
Позволяет понять:
- что спрашивают пользователи;
- какие документы находятся;
- где система ошибается;
- сколько стоит запрос;
- где требуется доработка.
Поэтому полноценный RAG — это не просто:
ChatGPT + папка PDF.
Какие данные можно подключать к RAG
RAG не ограничивается PDF-файлами.
Источниками могут быть:
- Word-документы;
- PDF;
- презентации;
- Excel;
- инструкции;
- техническая документация;
- договоры;
- внутренние регламенты;
- базы знаний;
- страницы сайта;
- CMS;
- корпоративный портал;
- CRM;
- ERP;
- тикеты службы поддержки;
- переписка;
- базы данных.
Но здесь появляется важное архитектурное различие.
Не любые данные нужно превращать в текст и складывать в векторную базу.
Например, если пользователю нужно узнать:
- текущий остаток товара;
- статус заказа;
- точную цену;
- сумму задолженности,
гораздо надёжнее запросить эти данные непосредственно из информационной системы.
RAG и структурированные данные
Представим запрос:
«Есть ли насос модели X на складе и сколько он сейчас стоит?»
Часть информации может находиться в документации:
- назначение;
- характеристики;
- ограничения.
Но актуальный остаток и цена хранятся в учётной системе.
Если загрузить вчерашнюю выгрузку прайса в RAG, уже сегодня ответ может стать неправильным.
Поэтому хорошее AI-решение может работать так:
характеристики товара → RAG;
цена и остаток → API или база данных.
А уже языковая модель объединяет информацию в один удобный ответ.
Это важная мысль:
RAG — не замена всем корпоративным интеграциям.
Он особенно полезен для работы с текстовыми и слабоструктурированными знаниями.
Какие задачи RAG решает в бизнесе
Область применения очень широкая, но особенно хорошо технология работает там, где ответ уже существует в корпоративных данных, а человеку долго искать его вручную.
Корпоративная база знаний
Сотрудник спрашивает:
«Как оформить командировку за границу?»
Без RAG:
- открывает портал;
- ищет регламент;
- находит несколько документов;
- проверяет актуальную версию;
- читает нужный раздел.
С RAG:
задаёт вопрос обычным языком и получает краткий ответ со ссылкой на действующий регламент.
Это особенно полезно в крупных компаниях, где внутренняя база знаний состоит из сотен или тысяч материалов.
Клиентская поддержка
AI-помощник может отвечать по:
- условиям обслуживания;
- тарифам;
- продуктам;
- гарантиям;
- инструкциям;
- доставке;
- возврату.
При этом ответы формируются не на основе общих знаний модели, а по данным самой компании.
Помощник оператора
Необязательно сразу разрешать нейросети самостоятельно отвечать клиенту.
Более безопасный сценарий:
клиент задаёт вопрос → RAG находит информацию → AI готовит черновик → оператор проверяет → отправляет.
Такой вариант позволяет получить пользу от технологии без полной автоматизации коммуникаций.
Консультант интернет-магазина
Например, покупатель спрашивает:
«Какой насос подойдёт для воды с небольшим содержанием песка?»
RAG может найти:
- технические характеристики;
- инструкции;
- рекомендации производителя;
- ограничения.
И на их основе подготовить сравнение подходящих вариантов.
При этом актуальные цены и остатки можно получать отдельно из каталога.
Техническая документация
Особенно интересный сценарий для:
- производства;
- промышленного оборудования;
- сервисных организаций;
- IT;
- инженерных компаний.
Специалист может спрашивать:
«Какой момент затяжки указан для этого соединения?»
или:
«Что означает код ошибки E147?»
Вместо ручного поиска по сотням страниц система находит нужный раздел.
HR и внутренние службы
Например:
- как оформить отпуск;
- как заказать оборудование;
- какие документы нужны для командировки;
- какие льготы доступны;
- как устроена процедура адаптации.
Большая часть подобных вопросов уже описана во внутренних документах, но сотрудники всё равно повторно задают их HR или административному отделу.
RAG способен снизить эту нагрузку.
Работа с договорами и юридическими документами
Система может помогать:
- искать нужные положения;
- сравнивать редакции;
- находить обязательства;
- собирать информацию из нескольких документов.
Но итоговые юридически значимые решения желательно оставлять специалисту.
Аналитика и исследования
Если компания хранит десятки отчётов, исследований и протоколов, RAG помогает задавать вопросы ко всему массиву данных сразу.
Например:
«В каких отчётах за последний год упоминалось снижение спроса в строительном сегменте?»
Система находит источники и формирует краткую сводку.
Что получает бизнес от RAG
Главное преимущество RAG — не сам факт использования нейросети.
Ценность возникает в изменении процесса работы с информацией.
Сотрудники быстрее находят ответы
Вместо ручного поиска по документам можно задать вопрос естественным языком.
Используются актуальные данные
Обновили источник — система начинает использовать новую информацию без переобучения всей LLM.
Ответ можно проверить
Пользователю можно показать документ и конкретный фрагмент, на основе которого сформирован ответ.
Снижается нагрузка на экспертов
Специалистам не приходится десятки раз отвечать на один и тот же типовой вопрос.
Несколько источников превращаются в единый интерфейс
Сотруднику не обязательно знать, в каком именно документе лежит информация.
Проще масштабировать внутренние знания
Особенно когда сотрудников и документов становится много.
RAG не устраняет галлюцинации полностью
Это одно из главных ограничений технологии.
Иногда RAG продают примерно так:
«Подключаем документы — и нейросеть больше не выдумывает».
Это некорректно.
Ошибка может возникнуть на разных уровнях.
Найден неправильный документ
Запрос оказался неоднозначным.
Найден не тот фрагмент
Поиск выбрал текст, который выглядит релевантным, но не содержит нужного ответа.
В базе лежит устаревшая информация
В таком случае RAG очень уверенно даст устаревший ответ.
Контекст разорван
Например, условие находится в одном чанке, а исключение — в другом.
Ошиблась сама модель
Даже получив правильный текст, LLM может неправильно его интерпретировать.
Поэтому качественная RAG-система должна уметь не только отвечать.
Она должна уметь сказать:
«В доступных источниках недостаточно информации для ответа».
Это часто гораздо полезнее, чем красивый выдуманный текст.
Почему качество базы знаний важнее мощности нейросети
Представим корпоративную папку:
Инструкция новая.pdf;Инструкция новая финал.pdf;Инструкция новая финал 2.pdf;Инструкция актуальная.pdf;Инструкция старая НЕ ИСПОЛЬЗОВАТЬ.pdf.
Какой документ правильный?
Человек, который работает с этой папкой каждый день, возможно, знает.
RAG — нет.
Если загрузить всё как есть, поиск может регулярно находить устаревшую информацию.
То же происходит, если в базе:
- дубли;
- противоречащие документы;
- плохие сканы;
- ошибки распознавания;
- файлы без структуры;
- устаревшие данные.
Новая языковая модель сама по себе не решит эту проблему.
Поэтому хороший RAG-проект часто начинается не с выбора LLM или векторной базы.
Он начинается с аудита корпоративных знаний.
Если человек не может понять, какой документ актуальный, RAG тоже будет испытывать проблемы.
Как RAG понимает, какой документ актуальный
Сам по себе — никак.
Эту логику нужно создавать.
Например, использовать метаданные:
- дата;
- номер версии;
- статус;
- владелец документа;
- тип материала;
- продукт;
- регион;
- подразделение.
Допустим, существуют три версии прайса.
Система может быть настроена так, чтобы в поиске участвовала только версия со статусом:
«Действует».
Или чтобы при конфликте приоритет получал документ с более новой датой.
То есть хорошая база знаний — это не просто папка, куда автоматически загрузили всё содержимое корпоративного диска.
Нужна логика управления знаниями.
RAG и права доступа
Корпоративная база редко полностью открыта всем сотрудникам.
Например:
- менеджер должен видеть прайс и каталог;
- HR — кадровые документы;
- бухгалтерия — финансовые регламенты;
- рядовой сотрудник не должен получать информацию о зарплатах коллег.
Если RAG подключён ко всем этим источникам, он обязан учитывать права доступа.
В противном случае пользователь может получить через AI информацию, которую никогда не смог бы открыть напрямую.
Поэтому корпоративный RAG должен учитывать:
- учётную запись пользователя;
- роль;
- подразделение;
- уровень доступа;
- доступ к конкретным источникам.
Главный принцип:
ИИ-помощник не должен предоставлять пользователю больше информации, чем доступно ему в исходных системах.
Облачный или локальный RAG
RAG-система может быть построена по-разному.
Облачное решение
Часть компонентов работает в инфраструктуре внешнего провайдера.
Преимущества:
- быстрее запуск;
- проще масштабировать;
- меньше собственной инфраструктуры;
- доступны готовые сервисы.
Локальное решение
Компоненты разворачиваются в собственной инфраструктуре или закрытом корпоративном контуре.
Это может быть важно, если:
- существуют строгие требования к обработке данных;
- запрещена передача определённой информации внешним сервисам;
- инфраструктура должна работать без доступа к интернету;
- компания хочет максимально контролировать стек.
При этом локальное размещение не означает автоматически «безопасно», а облако — «небезопасно».
Безопасность зависит от конкретной архитектуры, доступа, шифрования, моделей угроз и процессов эксплуатации.
RAG или просто загрузить документы в ChatGPT
Иногда полноценную RAG-систему действительно создавать не нужно.
Представим:
у специалиста пять документов.
Он раз в неделю хочет задать по ним несколько вопросов.
В таком случае загрузить файлы непосредственно в AI-сервис может быть значительно проще.
Собственная RAG-инфраструктура становится интереснее, когда:
- документов сотни или тысячи;
- они постоянно обновляются;
- пользователей много;
- нужны права доступа;
- необходимо автоматически обновлять базу;
- требуется подключение разных источников;
- нужны логи и аналитика;
- важно контролировать источники;
- решение должно быть встроено в корпоративные системы.
То есть RAG — это не способ «задать вопрос PDF».
Это способ организовать масштабируемую систему работы с корпоративными знаниями.
Когда RAG вообще не нужен
RAG стал популярным термином, поэтому его иногда пытаются использовать в любом AI-проекте.
Это ошибка.
Если дополнительные данные не нужны
Например:
«Перепиши текст в более официальном стиле».
Модели не нужна корпоративная база знаний.
Если данных очень мало
Если необходимые инструкции помещаются непосредственно в промпт или контекст, отдельный поисковый слой может быть излишним.
Если нужен только поиск документов
Иногда пользователю нужно не получить AI-ответ, а найти оригинальный документ.
Тогда качественный корпоративный поиск может оказаться проще и надёжнее.
Если нужна гарантированная детерминированная точность
Например, расчёт предельно допустимой нагрузки или дозировки реагента.
Для таких задач результат должен получать специализированный алгоритм или расчётная система.
Языковая модель может объяснить результат, но не должна заменять критически важный расчёт.
Если база знаний находится в хаосе
Сначала нужно привести в порядок данные.
Иначе RAG просто сделает хаотичную информацию более удобной для быстрого получения неправильных ответов.
RAG или fine-tuning: в чём разница
Эти технологии часто смешивают.
Но они решают разные задачи.
Упрощённо:
RAG меняет информацию, которая доступна модели при конкретном ответе.
Fine-tuning изменяет поведение самой модели.
Например:
Нужно научить AI использовать новый прайс
RAG.
Нужно, чтобы помощник отвечал строго в заданном формате
В некоторых случаях — fine-tuning.
Нужно регулярно обновлять факты
RAG.
Нужно закрепить стиль и тип поведения
Fine-tuning.
| Параметр | RAG | Fine-tuning |
|---|---|---|
| Актуальные факты | Хорошо подходит | Неудобно для частых изменений |
| Регулярное обновление данных | Обновляется база | Может потребоваться новое обучение |
| Ссылки на источники | Можно реализовать | Обычно не является основной возможностью |
| Корпоративная база знаний | Основной сценарий | Не лучший способ хранения знаний |
| Стиль ответа | Можно задавать инструкциями | Хорошо подходит |
| Специфическое поведение модели | Ограниченно | Один из основных сценариев |
На практике технологии могут использоваться совместно.
RAG или большое контекстное окно
Современные языковые модели способны принимать большие объёмы текста.
Возникает вопрос:
зачем вообще искать фрагменты, если можно каждый раз отправлять модели все документы?
Иногда действительно можно.
Например, если документов немного.
Но по мере роста базы появляются проблемы:
- увеличивается стоимость запросов;
- растёт время ответа;
- в контекст попадает много ненужного текста;
- сложнее контролировать права доступа;
- увеличивается информационный шум.
RAG пытается передать модели не всё, что есть у компании, а только то, что относится к конкретному вопросу.
Поэтому выбор зависит от масштаба.
Небольшой объём данных → длинного контекста может быть достаточно.
Большая регулярно обновляемая база → retrieval становится намного полезнее.
RAG и семантический поиск — это одно и то же?
Нет.
Семантический поиск отвечает примерно на задачу:
«Какие документы или фрагменты наиболее близки к моему вопросу?»
RAG делает следующий шаг:
вопрос → поиск → найденные материалы → готовый ответ.
Например:
семантический поиск возвращает три инструкции.
RAG прочитает найденные фрагменты и сформирует:
«Гарантийный срок составляет 24 месяца. Исключение — расходные компоненты. Источник: руководство по эксплуатации, раздел 8».
То есть retrieval — часть RAG, но не весь RAG.
RAG или ИИ-агент: в чём разница
RAG и агент — не конкурирующие технологии.
Они решают разные задачи.
RAG находит и предоставляет знания.
ИИ-агент использует знания для принятия решений и выполнения действий.
Например, пользователь спрашивает:
«Можно ли дать этому клиенту скидку 15%?»
RAG может найти документ:
«Политика предоставления скидок».
И показать правило:
менеджер самостоятельно согласует до 10%, более крупная скидка требует согласования руководителя.
На этом задача RAG закончена.
ИИ-агент может пойти дальше:
- найти клиента в CRM;
- проверить размер сделки;
- получить историю покупок;
- обратиться к RAG за политикой скидок;
- определить, что требуется согласование;
- создать задачу руководителю.
То есть RAG может быть одним из инструментов агента.
Что такое GraphRAG
Классический RAG обычно работает с фрагментами документов.
Но иногда пользователю важны не только тексты, но и связи между сущностями.
Например:
клиент → договор → проект → установленное оборудование → сервисная заявка → ответственный сотрудник.
Такие связи можно дополнительно представить в виде графа знаний.
Подходы, объединяющие retrieval с графовыми структурами, часто называют GraphRAG.
Они могут быть полезны для сложных аналитических задач и систем, где отношения между объектами критически важны.
Но обычному бизнесу не стоит начинать RAG-проект сразу с GraphRAG только потому, что термин звучит современно.
Сначала необходимо понять:
есть ли проблема, которую обычный поиск действительно не решает.
Архитектуру следует усложнять только тогда, когда это улучшает измеримый результат.
Как проходит внедрение RAG-системы
Хороший проект начинается не с выбора векторной базы.
Этап 1. Определяем бизнес-сценарий
Плохая постановка:
«Хотим внедрить RAG».
Хорошая:
«Сотрудники службы поддержки тратят в среднем 15 минут, чтобы найти информацию в технической документации».
Или:
«80% внутренних вопросов HR уже описаны в регламентах, но сотрудники продолжают писать специалистам».
Этап 2. Анализируем источники
Нужно понять:
- где находятся знания;
- в каком формате;
- кто отвечает за документы;
- насколько они актуальны;
- есть ли дубли;
- кто имеет к ним доступ.
Этап 3. Готовим базу знаний
Возможно, потребуется:
- удалить устаревшие версии;
- распознать сканы;
- нормализовать структуру;
- добавить метаданные;
- назначить владельцев.
Этап 4. Настраиваем загрузку и обновление
RAG не должен работать на моментальном «слепке», который через полгода станет устаревшим.
Нужно определить, как изменения будут попадать в систему.
Этап 5. Настраиваем chunking и поиск
Выбираем:
- способ разбиения;
- embeddings;
- retrieval;
- фильтры;
- reranking.
Этап 6. Подключаем языковую модель
Определяем инструкции:
- как формировать ответ;
- как цитировать источники;
- что делать при нехватке информации.
Этап 7. Учитываем права доступа
Особенно для корпоративной системы.
Этап 8. Формируем набор тестовых вопросов
Лучше использовать реальные вопросы пользователей.
Этап 9. Тестируем качество
Проверяем отдельно:
нашёлся ли правильный источник;
и:
правильно ли модель сформировала ответ.
Этап 10. Запускаем пилот
Например, на одном отделе или одной группе документов.
Этап 11. Масштабируем
Только после того, как подтверждено качество и понятна экономика.
Почему нельзя оценивать RAG фразой «вроде отвечает нормально»
Во время демонстрации практически любая AI-система может впечатлить.
Разработчик задаёт пять знакомых вопросов.
На четыре система отвечает правильно.
Все довольны.
Но после запуска сотрудники задают сотни запросов совершенно по-разному.
Поэтому нужен системный тестовый набор.
Например:
100 реальных вопросов.
Для каждого заранее известно:
- правильный ответ;
- правильный документ;
- нужный фрагмент.
После этого можно измерить качество.
Это позволяет сравнивать:
- разные способы chunking;
- разные embeddings;
- разные поисковые алгоритмы;
- разные модели;
- разные настройки reranking.
То есть RAG превращается из субъективного:
«мне кажется, хорошо отвечает»
в систему, качество которой можно измерять.
Какие метрики RAG нужно измерять
Условно метрики можно разделить на три группы.
Качество поиска
Главный вопрос:
нашла ли система правильный источник?
Если нужный документ не попал в контекст, даже лучшая модель не сможет корректно ответить.
Качество генерации
Правильно ли модель использовала найденную информацию?
Не добавила ли лишних фактов?
Не исказила ли смысл?
Бизнес-метрики
Например:
- доля успешно отвеченных вопросов;
- процент ответов со ссылкой на источник;
- количество эскалаций специалисту;
- время ответа;
- среднее время поиска информации сотрудником;
- стоимость одного запроса;
- экономия рабочих часов;
- снижение нагрузки на поддержку.
И это даёт важное правило диагностики.
Если RAG отвечает неправильно, сначала нужно выяснить:
плохой retrieval или плохая генерация?
Если системе дали неправильный документ, смена LLM может вообще ничего не исправить.
Как должен вести себя RAG, если ответа нет
Это один из главных признаков зрелой системы.
Представим вопрос:
«Какая скидка действует для партнёров категории Platinum?»
Но такой информации в подключённых документах нет.
Плохой AI-помощник пытается придумать ответ.
Хороший говорит:
«В доступной базе знаний я не нашёл информации о такой категории партнёров».
И дальше может:
- показать близкие документы;
- предложить уточнить вопрос;
- направить запрос эксперту;
- создать тикет.
Для корпоративного AI умение отказаться от ответа иногда важнее, чем способность ответить на любой вопрос.
Сколько стоит разработка RAG-системы
Универсальной цены нет.
Два проекта под названием «корпоративный RAG» могут отличаться по сложности в десятки раз.
На стоимость влияют:
Объём и состояние данных
Тысяча хорошо структурированных документов и тысяча сканов разного качества — совершенно разные проекты.
Количество источников
Папка документов проще, чем связка:
корпоративный портал + CRM + сайт + SharePoint + база техдокументации.
Частота обновления
Одни данные обновляются раз в квартал.
Другие — ежедневно.
Права доступа
Корпоративная система с десятками ролей сложнее публичной базы знаний.
Качество поиска
Простой векторный retrieval дешевле сложной схемы с гибридным поиском, фильтрами и reranking.
Интерфейс
Это может быть простой чат или полноценный корпоративный помощник.
Интеграции
Например, с CRM, порталом или службой поддержки.
Требования к инфраструктуре
Облачный сервис и закрытый локальный контур существенно отличаются.
Поэтому корректная стоимость определяется после анализа сценария и данных.
Из чего складывается стоимость эксплуатации
После запуска остаются постоянные расходы.
Например:
- запросы к LLM;
- создание embeddings;
- инфраструктура;
- векторная база;
- хранение;
- обновление индекса;
- API;
- мониторинг;
- техническая поддержка.
Один из полезных показателей:
стоимость одного качественного ответа.
Важно именно «качественного».
Очень дешёвая система, которая регулярно ошибается, может обходиться бизнесу значительно дороже из-за последствий таких ошибок.
Как посчитать экономику RAG
Представим компанию из 50 сотрудников.
Каждый в среднем тратит 20 минут в рабочий день на поиск информации:
- инструкций;
- регламентов;
- шаблонов;
- ответов на внутренние вопросы.
Получается:
50 × 20 минут = 1 000 минут в день.
Это примерно 16,7 рабочего часа каждый день.
За 21 рабочий день:
около 350 человеко-часов в месяц.
Предположим, после внедрения корпоративного помощника среднее время поиска снизилось с 20 до пяти минут.
Тогда экономится примерно 75% времени процесса.
Но экономику лучше считать не только через стоимость часа.
Дополнительный эффект может возникнуть за счёт:
- более быстрого ответа клиенту;
- сокращения нагрузки на опытных специалистов;
- уменьшения количества ошибок;
- ускорения адаптации новых сотрудников;
- способности отдела обработать больше обращений.
После этого экономический эффект сравнивается с:
- стоимостью внедрения;
- лицензиями;
- инфраструктурой;
- эксплуатацией.
Так RAG превращается из «интересного AI-проекта» в обычную инвестицию, которую можно оценить.
Основные ошибки при внедрении RAG
Загружать в систему всё подряд
Большая база не обязательно лучше.
Некачественные источники ухудшают ответы.
Не управлять версиями документов
Система начинает использовать устаревшие регламенты.
Плохо делить документы на чанки
Можно потерять контекст.
Полагаться только на один вид поиска
Некоторые данные требуют точного текстового поиска или фильтрации.
Не использовать метаданные
Дата, продукт, категория, подразделение и версия могут значительно помочь retrieval.
Тестировать только итоговый ответ
Нужно отдельно смотреть, какие документы нашла система.
Не показывать источник
Проверяемость особенно важна в корпоративном использовании.
Игнорировать права доступа
В результате AI может открыть пользователю закрытую информацию.
Пытаться решить любую проблему сменой модели
Иногда проблема находится в документах или retrieval.
Не настроить обновление базы
RAG постепенно начинает отвечать по устаревшей информации.
Использовать RAG там, где достаточно промпта
Не каждое AI-приложение требует собственной базы знаний.
Как выбрать подрядчика для разработки RAG
До начала проекта стоит выяснить не название используемой векторной базы, а подход подрядчика к данным и качеству.
Полезно задать вопросы:
- Какие источники будут подключены?
- Как данные будут обновляться?
- Как обрабатываются дубли и версии документов?
- Как будет выполняться chunking?
- Какой тип поиска планируется использовать?
- Нужен ли гибридный поиск?
- Будет ли использоваться reranking?
- Как система показывает источники?
- Как учитываются права доступа?
- Что происходит, если ответ не найден?
- Как формируется тестовый набор?
- Как отдельно оценивается качество retrieval?
- Какими метриками измеряется итоговое качество?
- Сколько стоит обработка одного запроса?
- Как решение сопровождается после запуска?
Формулировка:
«Загрузим ваши PDF в векторную базу и подключим ChatGPT»
может быть достаточной для демонстрационного прототипа.
Но сама по себе она ещё не описывает качественную корпоративную RAG-систему.
Частые вопросы о RAG
Что такое RAG?
RAG — подход, при котором нейросеть перед ответом получает информацию из внешней базы знаний и формирует ответ на основе найденных данных.
Как расшифровывается RAG?
Retrieval-Augmented Generation — генерация с дополненной выборкой.
Чем RAG отличается от обычного ChatGPT?
Обычная модель в основном опирается на свои знания и предоставленный контекст.
RAG автоматически ищет дополнительную информацию в подключённых источниках перед каждым ответом.
Уменьшает ли RAG галлюцинации?
Да, использование конкретных источников может заметно снизить количество выдуманных фактов.
Но полностью исключить ошибки RAG не может.
Может ли RAG ошибаться?
Да.
Ошибка может возникнуть в поиске, данных или генерации ответа.
Что такое векторная база?
Это система, которая позволяет хранить и искать векторные представления данных, например текстовых фрагментов.
Она часто используется для семантического поиска в RAG.
Что такое embeddings?
Это числовые представления текста или других данных, которые позволяют сравнивать их по смысловой близости.
Что такое chunking?
Разделение больших документов на меньшие логические фрагменты — чанки.
Какие документы можно подключить?
Практически любые источники, из которых можно корректно извлечь данные: PDF, Word, страницы сайта, инструкции, регламенты и другие материалы.
Может ли RAG работать с CRM или 1С?
Да, но способ интеграции зависит от конкретной системы.
При этом для точных структурированных данных иногда правильнее использовать прямой API или запрос к базе, а RAG оставить для текстовой информации.
Всегда ли нужна векторная база?
Нет.
Архитектура зависит от задачи. Могут использоваться обычный поиск, гибридный поиск и другие методы.
Чем RAG отличается от fine-tuning?
RAG передаёт модели внешние знания во время ответа.
Fine-tuning меняет параметры и поведение самой модели.
Что лучше: RAG или длинный контекст?
Для небольшого объёма информации может быть достаточно длинного контекста.
Для большой постоянно обновляемой базы retrieval обычно удобнее и экономичнее.
RAG и ИИ-агент — одно и то же?
Нет.
RAG предоставляет знания.
ИИ-агент способен использовать эти знания для принятия решений и выполнения действий.
Можно ли развернуть RAG локально?
Да.
Это может быть необходимо для закрытых корпоративных контуров и сценариев с особыми требованиями к данным.
Сколько стоит RAG?
Цена зависит от количества источников, состояния данных, масштаба базы знаний, прав доступа, интеграций и требований к инфраструктуре.
Сколько времени занимает внедрение?
Небольшой пилот на ограниченной базе можно запустить значительно быстрее полноценной корпоративной системы.
Поэтому лучше начинать с одного конкретного сценария и масштабировать решение после проверки качества.
Главное: когда бизнесу действительно нужен RAG
RAG не нужен просто потому, что компания хочет использовать искусственный интеллект.
Полезно начинать с более простого вопроса:
где сегодня сотрудники или клиенты регулярно ищут ответы, которые уже существуют внутри корпоративных данных?
Дальше схема выглядит так.
- Нужно просто генерировать текст → RAG не нужен.
- Нужно работать с несколькими небольшими документами → возможно, достаточно передавать их непосредственно модели.
- Нужно только находить документы → возможно, достаточно корпоративного поиска.
- Нужно получать готовые ответы по большой и постоянно обновляющейся базе знаний → стоит рассматривать RAG.
- Нужно после получения ответа ещё что-то выполнить в корпоративных системах → RAG можно использовать вместе с ИИ-агентом.
Поэтому RAG — это не технология про «загрузить PDF в нейросеть».
Это способ построить управляемый слой между корпоративными знаниями и языковой моделью.
Он становится действительно полезным тогда, когда информация уже есть внутри компании, но сотрудникам или клиентам долго, сложно или дорого находить её вручную.
А главный вопрос перед внедрением должен звучать не:
«Какую векторную базу выбрать?»
а:
«Какие вопросы регулярно возникают у наших сотрудников или клиентов, где сейчас находятся ответы на них и сколько времени и денег мы тратим на их поиск?»
Если этот процесс измерим, знания достаточно качественные, а экономический эффект превышает стоимость разработки и эксплуатации, RAG превращается из модного AI-термина в практический инструмент работы с корпоративными данными.
Давайте начнём сотрудничество!
Другие статьи


При переходе по
страницам сайта скидка
копится быстрее
Заполни форму
и крути барабан!
Поможем разобраться во всех тонкостях эффективного привлечения клиентов
с помощью интернет маркетинга
